
Welcher Entwickler kennt die Situation nicht? Man kommt auf ein neues Projekt, arbeitet sich ein, setzt die ersten Changes um und merkt, dass man irgendwie ausgebremst wird. Oberflächlich ist alles in Ordnung: Die Architektur ist klar, die CI/CD-Pipelines laufen, die Entwicklung kommt voran. Und trotzdem dauert jeder einzelne Change länger als nötig, weil man permanent mit Tooling und Abläufen kämpft statt mit dem eigentlichen Problem.
Genau diese Situation haben wir in einem Modernisierungsprojekt bei einem Schweizer Versicherer angetroffen. In diesem ersten Teil schauen wir uns an, woher die Reibung kam. Der bald erscheinende zweite Teil widmet sich dann der konkreten Umsetzung mit Fokus auf CI/CD.
Ausgangslage
Im Zentrum stand eine Offertenrechner-Applikation für den Vertrieb von Versicherungen, mit der
Offerte als zentraler Entität. Die Architektur war bereits finalisiert; hier die relevanten Infos
dazu:
- Eine zentrale Java Domain Model Library, die die Business-Logik bzw. das Domain Model nach Domain-Driven-Design-Prinzipien kapselt. Dieselben Klassen dienten gleichzeitig als Persistenz- und als DTO-Modell (JSON via Jackson).
- Mehrere Quarkus-Backend-Microservices, die allesamt von der Domain Model Library abhängen
- Ein Angular-Frontend, das ebenfalls von der Domain Model Library abhängt, und zwar über TypeScript-Definitionen für die DTOs, die aus den Java-Klassen generiert werden.
- Apache Maven als Java Build-System
18 Monate nach Projektbeginn, noch 12 Monate bis zum Go-Live, 11 Entwickler. Entsprechend hoch war der Grad an paralleler Entwicklung. Wie in DDD üblich erforderten die meisten Umsetzungen eine Anpassung am Domain Model.
    flowchart LR
  subgraph domainRepo["Repository: domain-model"]
    domainModule["Maven Module<br/>domain-model"]
    domainJar["Artifact<br/>domain-model.jar"]
    tsTypes["Artifact<br/>domain-model-types.d.ts"]
    domainModule --> domainJar
    domainModule --> tsTypes
  end

  subgraph frontendRepo["Repository: frontend"]
    frontendApp["Angular App<br/>offer-ui"]
  end

  subgraph bffRepo["Repository: bff-service"]
    bffService["Quarkus Service<br/>Backend for Frontend"]
  end

  subgraph documentRepo["Repository: document-service"]
    documentService["Quarkus Service<br/>Documents"]
  end

  subgraph apiRepo["Repository: api-server"]
    apiServer["Quarkus Service<br/>API Server"]
  end

  domainJar --> bffService
  domainJar --> documentService
  domainJar --> apiServer

  tsTypes --> frontendApp

  classDef critical fill:#ffdddd,stroke:#d32f2f,stroke-width:3px,color:#111;
  class domainModule critical
  class domainJar critical
  class tsTypes critical
Ein harmloser Change: neues Feld, neues Kommando
Nehmen wir eine kleine, alltägliche Anforderung: Die Offerte soll neu ein Zahlungsintervall
führen (monatlich, halbjährlich, jährlich), und es braucht ein Kommando ChangeZahlungsintervall,
um diesen Wert zu setzen. Fachlich ist das ein in sich geschlossener, überschaubarer Change.
Schauen wir uns an, was es braucht, bis dieser Change auf der Testumgebung eingespielt ist.
Code-Anpassung, lokales Testing
Im Source Code werden drei Module angepasst:
- Feld
zahlungsintervallund KommandoChangeZahlungsintervallim Domain Model ergänzt - Anzeige des Felds im Formular und Absetzen des Kommandos im Frontend
- Aufruf des Getters im Document Service, um das Zahlungsintervall auf dem Versicherungsantrag-PDF anzuzeigen
Pain Point: Schon dieser kleine Change verteilt sich über mehrere Repositories und ggf. IntelliJ-Workspaces1. Es entstehen mehrere Commits.
Pain Point: Damit die Services die Änderung überhaupt sehen, muss die Version der Domain Model Library manuell auf eine
SNAPSHOT-Version angepasst werden. Bei jeder einzelnen Iteration im Domain Model muss einmvn installausgeführt werden. Auf der Frontend-Seite dasselbe Spiel mitnpm install, um die TypeScript-DTO-Definitionen zu aktualisieren.
Refactoring
Beim lokalen Testen fällt auf, dass der Feldname unglücklich gewählt war. Also benennen wir das Feld
im Domain Model um. Den Getter-Aufruf im Document Service müssen wir von Hand nachziehen. Und
danach wieder ein mvn install und npm install ausführen.
Pain Point: Die Refactoring-Funktionen von IntelliJ greifen nicht über die Modulgrenze hinweg. Der Document Service kennt nur das JAR der Library, nicht deren Quellcode. Was eigentlich ein automatisiertes Rename wäre, wird zur manuellen Search-and-Replace-Aufgabe. In diesem Fall nicht kritisch, aber bei komplexen Refactorings eine bedeutende Fehlerquelle.
Pull Requests erstellen
Jetzt geht es ins Code Review. Es werden mehrere Pull Requests erstellt:
- einer für das Domain Model
- einer für das Frontend
- einer pro Backend Service (neue Domain-Model-Version in jedem
pom.xml)
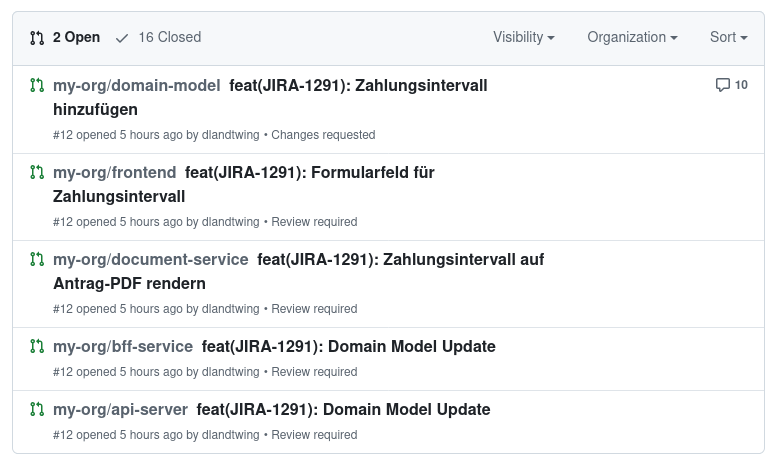
Ein funktionaler Change, verteilt über mehrere Pull Requests mit derselben Ticket-Nummer.
Pain Point: Ein kleiner, zusammenhängender funktionaler Change ist über mehrere Pull Requests und Repositories verteilt. Das erzeugt nicht nur Aufwand, es macht es dem Reviewer schwer, den Überblick zu behalten oder die Änderung sinnvoll in der IDE durchzugehen. Zum lokalen Review müssten mehrere Branches über mehrere Repositories ausgecheckt werden.
Pain Point: Die abhängigen Pull Requests lassen sich erst finalisieren, wenn der Domain-Model-PR gemerged ist, eine Version erhalten hat und ins Maven- und npm-Repository publiziert wurde. Das verlängert die Durchlaufzeit eines einzelnen Changes erheblich und bremst die Entwicklung spürbar aus.
Domain-Model-PR mergen, Service-PRs aktualisieren
In der Zwischenzeit hat ein Kollege einen anderen Change gemerged, der eine Methodensignatur im
Domain Model angepasst hat. Wir mergen unseren eigenen Domain-Model-Change und warten den Publish
ins Maven- und npm-Repository ab. Danach tragen wir in unseren Service-PRs die neue Version als
Dependency ein. Und beim Build eines Services, den wir abgesehen von der Domain-Model-Version im
pom.xml nicht angepasst haben, failed der Compiler.
[INFO] -----------------< ch.ltsc.offerte:offerte-api-server >-----------------
[INFO] Building offerte-api-server 1.0.0-SNAPSHOT
[INFO]   from pom.xml
[INFO] --------------------------------[ jar ]---------------------------------
[...]
[INFO] --- compiler:3.13.0:compile (default-compile) @ offerte-api-server ---
[...]
[ERROR] /workspace/offerte-api-server/src/main/java/ch/ltsc/offerte/api/OfferteResource.java:[30,36] invalid method reference
  cannot find symbol
    symbol:   method getVersicherungsnehmerName()
    location: class ch.ltsc.offerte.domain.Offerte
[INFO] 1 error
Was ist passiert? Der Service ruft eine Methode auf, deren Signatur im fremden PR geändert wurde. Der Service selbst wurde aber noch nicht auf die neue Signatur angepasst. Damit unser eigener Build durchläuft, müssen wir die Anpassung aus dem bereits gemergten PR erst in den Service übernehmen: entweder selbst umsetzen oder darauf warten, dass es jemand anders tut.
Pain Point: Pull Requests kommen sich gegenseitig in die Quere, weil Changes am Domain Model und an den Services unabhängig voneinander gemerged werden, obwohl sie technisch voneinander abhängen.
Bei einem grossen Team und häufigen Domain-Model-Changes verschärft sich dieses Problem deutlich.
Service-PRs mergen und deployen
Schliesslich mergen wir alle Pull Requests. Im Repository tragen nun alle Services und das Frontend
dieselbe Domain-Model-Version. Wir warten ein paar Minuten auf das automatische Deployment und
testen den Change in der Testumgebung und stossen auf eine unerwartete NullPointerException.
Was ist passiert? Im Repository referenzieren zwar alle Services dieselbe Version des Domain Models, aber nicht alle Services laufen auch tatsächlich mit dieser Version. Vielleicht ist das Deployment noch nicht für alle Services abgeschlossen, weil einzelne Pipeline-Runs noch auf einen freien Runner warten. Vielleicht ist eine Deployment-Pipeline fehlgeschlagen. So oder so: Für einen Moment (manchmal auch länger) sind inkompatible Versionen aktiv.
Pain Point: Weil die Deployments unabhängig voneinander laufen, sind kurzzeitig (und manchmal länger) inkompatible Versionen deployt.
Pain Point: Es ist umständlich herauszufinden, welche Service-Versionen überhaupt zueinander kompatibel sind.
Ein Schritt zurück: Wo liegt das Hauptproblem?
Wenn man die fünf Schritte nebeneinanderlegt, zeigt sich ein gemeinsames Muster. Die Reibung entsteht nicht an einer einzelnen Stelle, sondern aus einer strukturellen Problematik:
Die Services sind stark an das Domain Model gekoppelt, werden aber separat versioniert. Dazu kommt eine unsichtbare Kopplung zwischen den Services untereinander, etwa über gemeinsam genutzte DTOs. Funktional zusammenhängende Changes müssen dadurch technisch in getrennte, manuell zu orchestrierende Einzelschritte zerlegt werden. Und durch die hohe Frequenz an Domain-Model-Changes zahlen wir diesen Preis nicht einmal, sondern ständig.
Monorepo: zusammen, was zusammengehört
Was ist ein Monorepo?
Mono steht für single: Ein Monorepo ist schlicht ein einzelnes Repository, das mehrere Module enthält. In unserem Fall versionieren wir das Domain Model, die Backend-Services und das Frontend gemeinsam.
Weshalb hilft das in dieser Situation?
Weil es das Problem an der Wurzel packt: Stark gekoppelte Services und Libraries werden gemeinsam versioniert. Damit fallen genau jene Reibungspunkte weg, die wir oben Schritt für Schritt durchgespielt haben. Gehen wir sie noch einmal durch.
Pain Point 1: IDE und Workspace
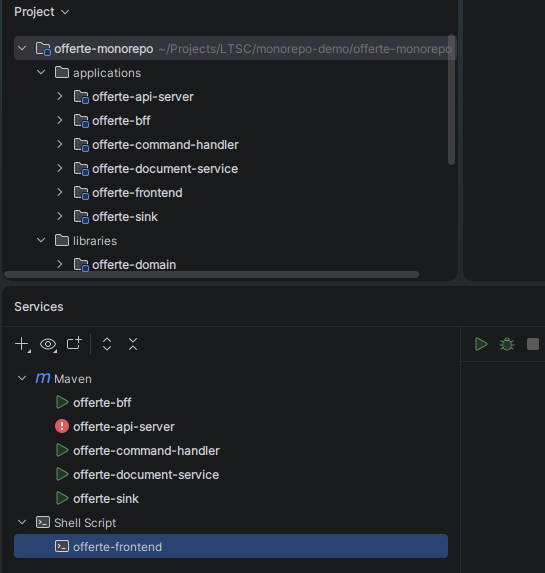
Ein einziger Workspace mit dem gesamten Project Tree über Services und Libraries hinweg.
Durch die gemeinsame Versionierung lässt sich ein einzelner Workspace für alle gekoppelten Services und Libraries einfach realisieren. Das Refactoring von Library-Code funktioniert wieder über das gesamte Projekt hinweg, die Navigation zwischen Service- und Library-Code ebenso, und für verschiedene Szenarien lassen sich vorbereitete Launch Configurations hinterlegen, was insbesondere neuen Entwicklern den Einstieg erleichtert.
Pain Point 2: lokales Testing
Die IDE erkennt die Abhängigkeiten zwischen Services und Libraries innerhalb des Workspaces und baut
die benötigten Abhängigkeiten automatisch. Das ständige mvn install entfällt. Auf der
Frontend-Seite werden die npm-Abhängigkeiten automatisch gelinkt und müssen nicht mehr manuell
installiert werden.
Pain Point 3: Pull Requests
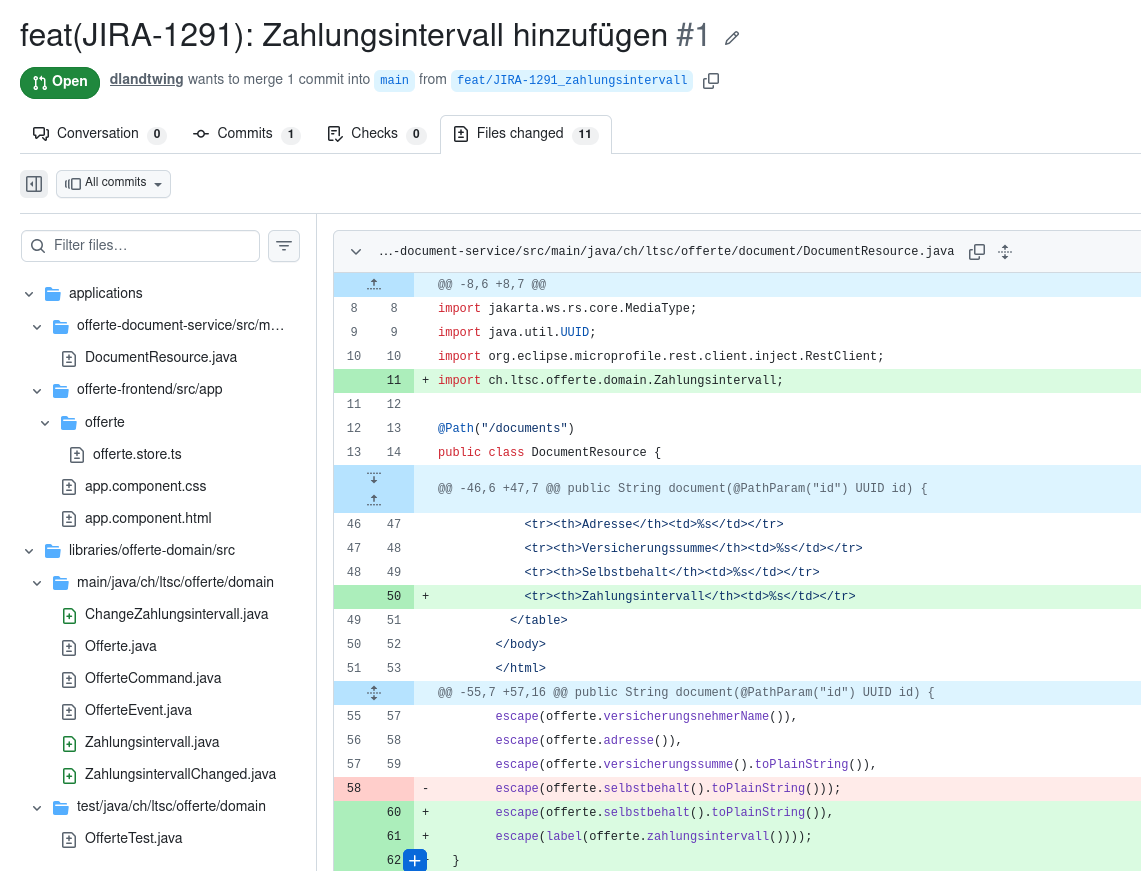
Ein einziger Pull Request mit dem Diff über alle betroffenen Services hinweg.
Ein funktionaler Change wird wieder zu einem Pull Request über alle gekoppelten Module hinweg.
Der komplette Change kann auf einmal reviewt und auf einmal gemerged werden. Und die mühsame Pflege
von Versionsnummern in den pom.xml-Dateien fällt weg.
Pain Point 4: blockierende Changes anderer Entwickler
Das Szenario aus Schritt 4 kann schlicht nicht mehr auftreten: Da die Abhängigkeiten gemeinsam mit den Services versioniert werden, ist ein Domain-Model-Change ohne die zugehörige Service-Anpassung gar nicht erst mergebar.
Pain Point 5: Deployment ohne inkompatible Versionen
Jedes automatische Deployment erzeugt einen GitOps-Change mit durchgängig konsistenten Versionen. Das Deployment geschieht atomar: Es werden entweder alle betroffenen Services deployt oder keiner davon.
diff --git a/kustomization.yaml b/kustomization.yaml
index 78c9157..e306322 100644
--- a/kustomization.yaml
+++ b/kustomization.yaml
@@ -12,14 +12,14 @@ resources:

 images:
   - name: registry.my-org.ch/offerte-proj/offerte-api-server
-    newTag: 1.42.0-snapshot.12
+    newTag: 1.42.0-snapshot.13
   - name: registry.my-org.ch/offerte-proj/offerte-bff
-    newTag: 1.42.0-snapshot.12
+    newTag: 1.42.0-snapshot.13
   - name: registry.my-org.ch/offerte-proj/offerte-command-handler
-    newTag: 1.42.0-snapshot.12
+    newTag: 1.42.0-snapshot.13
   - name: registry.my-org.ch/offerte-proj/offerte-document-service
-    newTag: 1.42.0-snapshot.12
+    newTag: 1.42.0-snapshot.13
   - name: registry.my-org.ch/offerte-proj/offerte-frontend
-    newTag: 1.42.0-snapshot.12
+    newTag: 1.42.0-snapshot.13
   - name: registry.my-org.ch/offerte-proj/offerte-sink
-    newTag: 1.42.0-snapshot.12
+    newTag: 1.42.0-snapshot.13
No Free Lunch
Wie mein Professor für Betriebssysteme und Compiler stets zu sagen pflegte:
There is no free lunch
— T. Gross
Der Umstieg auf ein Monorepo ist eine Investition. Auf der Aufwandsseite standen:
- ein Proof of Concept
- die Abstimmung mit Team und Architekturgremien
- das Engineering von CI/CD und IDE-Setup
- die eigentliche Migration der Polyrepos ins Monorepo
- Anleitungen und Support für die Entwickler beim Switch
- Pipeline-Troubleshooting
Dazu kommt eine dauerhaft höhere Komplexität in CI/CD: Möchte man nicht unnötig lange warten und Runner-Ressourcen verschwenden, muss bei jedem Change bestimmt werden, welche Builds überhaupt notwendig sind. Die Versionierung muss sauber gelöst sein, und auch das Deployment wird anspruchsvoller.
Fazit nach 12 Monaten Monorepo
Der Switch verlief reibungslos, und die Entwickler sind ausgesprochen zufrieden. Die positiven Erfahrungen haben sich schnell über das ursprüngliche Projektteam hinaus verbreitet: ein neues Projektteam hat den Ansatz übernommen, und eine Rückkehr zum Polyrepo-Modell steht für niemanden mehr zur Debatte.
CI/CD läuft nach einer anfänglichen Stabilisierungsphase sehr zuverlässig. Die spätere Einführung mehrstufiger Dependencies (eine neue Dependency hinter einer bestehenden Dependency hinter einem Service) hat kurzzeitig zu Instabilitäten geführt, die sich aber rasch beheben liessen. Fehler durch inkompatible Versionen fallen seither komplett weg. Unter dem Strich ein klarer Erfolg.
Learnings
Kopplung kritisch hinterfragen. Explizite wie implizite Kopplung sollte man nicht als gegeben hinnehmen. Unter Umständen lohnt sich eine Architekturanpassung, denn ohne diese Form der Kopplung hätte das Problem gar nicht erst gelöst werden müssen.
Team-Akzeptanz ist zentral. Ohne den Rückhalt im Team kommen Veränderungen gar nicht zustande,
oder man stösst nach der Einführung auf Widerstand. Ein Proof of Concept ist hier ein wichtiges
Hilfsmittel, um Vor- und Nachteile aufzuzeigen und Diskussionen zu führen.
Absolut kritisch für die Akzeptanz ist auch die aktive Unterstützung der Entwickler beim Switch: mit
Migrationsanleitungen, Scripts (Work-in-progress-Branches nicht vergessen) und Pair Programming.
Genauso wichtig ist eine gut getestete CI/CD-Pipeline vor dem Switch.
CI/CD-Know-how sollte verteilt sein. Spätestens sobald der Pipeline-Code grösstenteils stabil ist. Wenn die Pipeline wegen Abwesenheiten niemand betreuen kann, bremst das die gesamte Entwicklung aus.
Developer Experience ist ein wichtiger Erfolgsfaktor. Hindernisse führen zu Unterbrechungen (Warten auf Review) oder zu Workarounds (etwa dupliziertem Code) und bremsen schlussendlich den Fortschritt. Ein gutes IDE-Setup und ein effizienter Review- und Deployment-Prozess ermöglichen schnellere Lieferungen von Bugfixes und Features.
Je früher, desto besser. Die Vorteile wirken über die gesamte verbleibende Projektlaufzeit und
in der Weiterentwicklung. Früh eingeführt, zahlen sie sich entsprechend länger aus.
Den Zeitpunkt legt man am besten gezielt auf eine ruhigere Projektphase und stimmt ihn vorgängig im
Team ab, sonst riskiert man unnötigen Stress, falls etwas schiefläuft.
Damit ist die Warum-Frage beantwortet. Im bald erscheinenden zweiten Teil geht es um das Wie: wie wir die zusätzliche CI/CD-Komplexität in den Griff bekommen haben, von der Bestimmung der notwendigen Builds über die Versionierung bis zum atomaren Deployment.
IntelliJ unterstützt mehrere Repositories im selben Workspace. Die meisten Entwickler haben dies nicht genutzt. ↩︎